
Backlog warnings and resource-constrained prioritization of urban infrastructure service requests
Đào Ngọc Lâm
Đại học Kinh tế Quốc dân
Email: lamdao7325@gmail.com
Lê Thanh Lâm
THPT Chuyên Hà Nội Amsterdam
Email: Lamthanh.thcscg@gmail.com
Huỳnh Thị Minh Thư
Đại học Mở Hồ Chí Minh
Email: minhthuhuynh1097@gmail.com
Trần My Lan
Đại học Kinh tế Quốc dân
Email: lumi.lanmytran@gmail.com
(Quanlynhanuoc.vn) – Nghiên cứu xây dựng phương pháp cảnh báo phản ánh hạ tầng có khả năng tiếp tục chưa đóng sau 24 giờ và lựa chọn hồ sơ cần rà soát khi năng lực có hạn. Dữ liệu là bản xuất công khai gồm 58.261 bản ghi, trong đó 5.320 hồ sơ thuộc 10 nhóm hạ tầng hợp lệ. Các lát cắt hàng ngày được chia theo thời gian để học, lựa chọn tham số và kiểm tra. Mô hình xác suất làm trơn kết hợp loại phản ánh, tuổi hồ sơ và khu vực được so sánh với tỷ lệ chung, mô hình chỉ dùng loại và nguyên tắc đến trước xử lý trước. Trên 3.898 hồ sơ trong hai ngày kiểm tra, mô hình đầy đủ đạt điểm Brier 0,1162. Khi chỉ rà soát 20% hàng đợi, phương án này nhận diện 768 lượt tiếp tục chưa đóng, so với 731 của FIFO và 770 của mô hình chỉ dùng loại. Kết quả gợi ý cần được đánh giá riêng về chất lượng xác suất và chất lượng danh sách ưu tiên. Thực nghiệm chỉ mô phỏng phân bổ lượt rà soát, chưa chứng minh giảm tồn đọng hay rút ngắn sửa chữa thực tế.
Từ khóa: Hạ tầng đô thị; phản ánh người dân; cảnh báo tồn đọng; ưu tiên xử lý; giới hạn nguồn lực.
Abstract: This study develops a method to flag urban infrastructure requests likely to remain administratively open over the following 24 hours and to prioritize case review under limited capacity. A publicly available export contains 58,261 requests, of which 5,320 valid records belong to ten infrastructure categories. Daily snapshots are separated chronologically for training, parameter selection, and testing. A smoothed probability model combining request category, case age, and borough is compared with pooled and category-only estimates and a first-in, first-out policy. Across 3,898 case-snapshot observations on two test days, the full model achieves a Brier score of 0.1162. With review capacity limited to 20% of the queue, it identifies 768 observations that remain open, compared with 731 for FIFO and 770 for the category-only model. Better probability prediction therefore does not necessarily yield a better priority list at a specific budget. The evidence is exploratory because the export covers approximately one week, observations can repeat across snapshots, and administrative closure is not verified repair completion. The experiment evaluates review allocation rather than causal reductions in backlog or actual repair time.
Keywords: Urban infrastructure; citizen service requests; backlog warning; prioritization; resource constraints.
1. Đặt vấn đề
Phản ánh về mặt đường, đèn chiếu sáng, vỉa hè và hệ thống nước tạo ra một hàng đợi công việc có đặc điểm rất khác nhau. Một hồ sơ tín hiệu giao thông có thể được đóng nhanh, trong khi một hồ sơ đèn đường còn mở qua nhiều ngày. Khi cán bộ chỉ đủ thời gian rà soát một phần danh sách, nguyên tắc đến trước xử lý trước (FIFO) dễ bỏ qua những nhóm có nguy cơ tiếp tục tồn cao. Câu hỏi thực hành là: với cùng số lượt rà soát, cách sắp xếp nào tìm được nhiều hồ sơ cần theo dõi hơn?
Bài viết kiểm chứng một phương pháp xác suất đơn giản trên bộ dữ liệu. Mục tiêu gồm dự báo trạng thái chưa đóng sau 24 giờ, chuyển dự báo thành danh sách ưu tiên theo ngân sách và so sánh với FIFO. Đóng góp nằm ở thiết kế đánh giá gắn với năng lực xử lý, đồng thời phân biệt hồ sơ hành chính với sự cố hạ tầng ngoài hiện trường. Thành phố New York lưu ý rằng thời gian đóng yêu cầu không nhất thiết phản ánh thời gian hoàn thành công việc (City of New York, n.d.-b). Vì vậy, kết quả được diễn giải ở cấp hồ sơ, không coi là bằng chứng sửa xong công trình.
2. Cơ sở nghiên cứu
Cơ cấu phản ánh có thể mang thông tin về đặc điểm địa phương và hỗ trợ ra quyết định đô thị (Wang et al., 2016). Tuy nhiên, số người gửi phản ánh không đồng nhất với số sự cố hoặc mức độ nhu cầu thực. Kontokosta et al. (2017) chỉ ra nguy cơ sai lệch do khác biệt về xu hướng phản ánh giữa các nhóm dân cư. Do đó, bài viết không dùng số phản ánh làm trọng số thiệt hại hay bằng chứng về mức độ nguy hiểm.
Tussey và Yan (2025) nhấn mạnh kiểm soát chất lượng khi sử dụng dữ liệu NYC 311. Bài viết kế thừa yêu cầu kiểm tra thời gian, định nghĩa trường và khả năng tái lập; không khẳng định đây là thuật toán mới. Khoảng trống thực hành được khảo sát là sự khác biệt giữa dự báo xác suất tốt và lựa chọn danh sách tốt dưới một ngân sách cụ thể. Điểm Brier đánh giá sai số xác suất, còn precision và recall đánh giá danh sách được chọn; các chỉ số không thay thế nhau (scikit-learn developers, n.d.).
3. Phương pháp nghiên cứu
3.1. Nguồn dữ liệu và phạm vi
Bản sao gồm 58.261 dòng, không phải mẫu ngẫu nhiên đại diện cho toàn thành phố. Khoảng tiếp nhận của nhóm hạ tầng là 20/8/2025 đến đầu ngày 27/8/2025. Loại 13 dòng có ngày đóng trước ngày tạo; không phát hiện trùng mã trong nhóm đã chọn. Còn 5.320 hồ sơ hợp lệ thuộc mười loại ở Bảng 1. Tệp gốc được giữ nguyên và ghi SHA-256 vào results.json; mã phiên bản kho được lưu riêng nếu truy xuất thành công.
Thời điểm tiếp nhận và đóng được đọc theo giờ lịch địa phương ghi trong tệp. Khoảng nghiên cứu không đi qua lần chuyển giờ mùa hè, nên hiệu hai thời điểm không cần điều chỉnh DST. Không lấy trạng thái hiện tại hoặc mô tả kết quả xử lý làm biến dự báo. Ngày đóng chỉ dùng dựng hàng đợi và nhãn kết quả. Hồ sơ thiếu ngày đóng được xem là chưa có bằng chứng đóng trong bản xuất; đây là giả định quan sát, có thể sai khi dữ liệu cập nhật chậm. Không thay ngày thiếu bằng ngày tải.
3.2. Ý nghĩa tồn đọng
Tại 0 giờ ngày t, hàng đợi gồm các hồ sơ tiếp nhận từ 20/8, có ngày tạo trước t và chưa có ngày đóng không muộn hơn t. Nhãn y = 1 nếu vẫn chưa đóng tại t + 24 giờ; ngược lại y = 0. “Tồn đọng” trong bài là tiếp tục chưa đóng theo cửa sổ nghiên cứu, không đồng nghĩa vi phạm thời hạn cam kết (SLA). Mốc 24 giờ phục vụ nhịp rà soát hàng ngày, chưa phải chuẩn nghiệp vụ của mọi loại hạ tầng.
Hai lát cắt 21 và 22/8 tạo 1.618 lượt học từ 1.202 mã hồ sơ. Lát cắt 23/8 tạo 1.332 lượt lựa chọn tham số; nhãn đã quan sát đủ vào 24/8. Mô hình được giữ cố định trước khi kiểm tra tại 0 giờ ngày 25 và 26/8; nhãn cuối cùng kết thúc 0 giờ ngày 27/8. Tập kiểm tra có 3.898 lượt, tương ứng 2.436 mã, trong đó 3.302 lượt tiếp tục chưa đóng (84,71%). Một hồ sơ có thể xuất hiện nhiều ngày; đây là đơn vị hồ sơ-ngày, không phải các quan sát độc lập. Hàng đợi không bao gồm tồn từ trước 20/8.
3.3. Mô hình cảnh báo và phân bổ nguồn lực
Mô hình ước lượng tỷ lệ tiếp tục chưa đóng theo các nhóm và làm trơn về nhóm cha. Với nhóm g có n_g lượt học và s_g lượt mang nhãn 1, xác suất là:
p_g = (s_g + a × p_cha) / (n_g + a). (1)
Cấu trúc nhóm lần lượt là toàn bộ mẫu, loại phản ánh, loại kết hợp tuổi hồ sơ, rồi loại kết hợp tuổi và khu vực borough. Tuổi được chia thành dưới một ngày, từ một đến dưới hai ngày, và ít nhất hai ngày. Hai tầng đầu dùng a = 20 như quy tắc cố định trước khi kiểm tra; tầng khu vực thử a thuộc {5, 20, 50, 100} và chọn Brier thấp nhất trên tập lựa chọn tham số. Giá trị được chọn là 100. Nhóm chưa xuất hiện tự lùi về nhóm cha. Không sử dụng mã hồ sơ để học xác suất.
Giới hạn nguồn lực được mô hình hóa bằng số lượt rà soát, mỗi hồ sơ tiêu tốn một đơn vị. Tại mỗi lát cắt, chọn tối đa K = floor (q × N_t), với q bằng 10%, 20% hoặc 30%. Dưới lợi ích dự báo bằng p_i và chi phí đồng nhất, chọn K xác suất lớn nhất giải đúng bài toán:
max Σ p_i × x_i; Σ x_i ≤ K; x_i thuộc {0, 1}. (2)
Khi bằng xác suất, ưu tiên hồ sơ cũ hơn rồi mã hồ sơ theo thứ tự chữ để tái lập. FIFO chọn hồ sơ cũ nhất, cùng quy tắc phá hòa theo mã. Chọn ngẫu nhiên dùng kỳ vọng giải tích K × tỷ lệ nhãn 1 trong từng ngày, không phải một lần bốc mẫu. Phương án chỉ dùng loại và phương án loại cộng tuổi là các đối chứng loại bỏ thành phần. Mỗi ngày là một bài toán độc lập: việc được chọn không làm hồ sơ biến mất trong ngày kế tiếp. Thiết kế này đánh giá phân bổ rà soát trên lịch sử, chưa mô phỏng công suất sửa chữa hay tác động của can thiệp.
3.4. Chỉ số đánh giá
Điểm Brier là trung bình của (p_i – y_i)^2, càng thấp càng tốt. Average precision (AP) tổng hợp đường precision-recall, xử lý đồng hạng theo cùng ngưỡng xác suất. Precision@K là số lượt y = 1 trong danh sách chia K; recall@K chia cho tổng lượt y = 1 của hàng đợi. Khi gộp hai ngày, cộng tử và mẫu trước khi chia. Ngân sách là kịch bản giả định, nhãn kết quả lấy từ dữ liệu thật. Do chỉ có hai ngày kiểm tra và hồ sơ lặp giữa các ngày, không thực hiện kiểm định ý nghĩa hay báo khoảng tin cậy dựa trên giả định độc lập.
4. Kết quả và thảo luận
4.1. Cơ cấu hàng đợi theo loại phản ánh
Bảng 1. Hồ sơ tiếp nhận trước 0 giờ 27/8/2025 và tỷ lệ chưa đóng tại mốc này
| Loại phản ánh | Hồ sơ | Chưa đóng (%) |
| Street Condition | 1.247 | 41,78 |
| Traffic Signal Condition | 795 | 4,53 |
| Street Light Condition | 662 | 95,02 |
| Sidewalk Condition | 604 | 88,74 |
| Water System | 1.236 | 32,12 |
| Sewer | 411 | 31,87 |
| Curb Condition | 149 | 96,64 |
| Street Sign – Damaged | 94 | 55,32 |
| Street Sign – Dangling | 60 | 68,33 |
| Street Sign – Missing | 52 | 50,00 |
Bảng 1 chỉ tính hồ sơ tiếp nhận trước mốc quan sát, không đưa phần ngày 27/8 vào mẫu số. Đây là tỷ lệ tại một mốc, chịu ảnh hưởng bởi tuổi hồ sơ, không phải tỷ lệ vi phạm thời hạn hay so sánh hiệu suất đã hiệu chỉnh giữa cơ quan. Chênh lệch rõ giữa tín hiệu giao thông và đèn đường cho thấy, loại phản ánh là một biến phân tầng đáng kiểm tra. Các nhóm ít hồ sơ, chẳng hạn như biển báo, cần làm trơn để tránh xác suất cực đoan từ mẫu nhỏ.
Hình 1. Số lượt chưa đóng tại các lát cắt và số tiếp tục chưa đóng sau 24 giờ
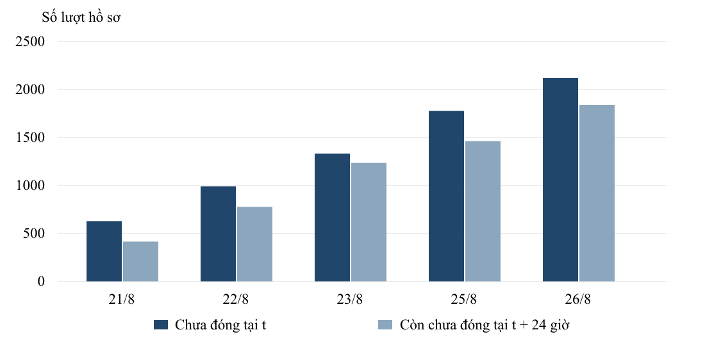
Hàng đợi quan sát tăng từ 627 lượt ngày 21/8 lên 2.120 lượt ngày 26/8. Mức tăng không đại diện toàn bộ tồn vì nghiên cứu bắt đầu một đoàn hệ mới từ 20/8 và chưa biết tồn cũ. Cột kết quả ngày 23/8 cao hơn tương đối cũng nhắc rằng cơ cấu nhãn thay đổi nhanh ngay trong một tuần.
4.2. Chất lượng dự báo xác suất
Bảng 2. Chất lượng dự báo trên 3.898 lượt kiểm tra ngày 25 và 26/8/2025
| Mô hình | Brier | AP |
| Chung | 0,1416 | 0,8471 |
| Loại | 0,1178 | 0,9454 |
| Loại + tuổi | 0,1181 | 0,9509 |
| Đầy đủ | 0,1162 | 0,9532 |
Mô hình đầy đủ có Brier 0,1162, giảm 17,90% tương đối so với tỷ lệ chung. Tuy nhiên, mức giảm so với mô hình chỉ dùng loại chỉ là 0,0016 điểm tuyệt đối. AP của tỷ lệ chung bằng tỷ lệ nhãn dương 0,8471, vốn đã cao; vì vậy, AP 0,9532 của mô hình đầy đủ không nên đọc thành độ chính xác phân loại 95,32%. Thêm tuổi hồ sơ riêng lẻ còn làm Brier tăng nhẹ từ 0,1178 lên 0,1181.
4.3. Lựa chọn ưu tiên theo ngân sách
Bảng 3. Kết quả chọn danh sách; số trúng là lượt tiếp tục chưa đóng sau 24 giờ
| Ngân sách | Cách chọn | Trúng/K | Precision (%) | Recall (%) |
| 10,00% | FIFO | 369/389 | 94,86 | 11,18 |
| 10,00% | Loại | 384/389 | 98,71 | 11,63 |
| 10,00% | Đầy đủ | 382/389 | 98,20 | 11,57 |
| 20,00% | FIFO | 731/779 | 93,84 | 22,14 |
| 20,00% | Loại | 770/779 | 98,84 | 23,32 |
| 20,00% | Đầy đủ | 768/779 | 98,59 | 23,26 |
| 30,00% | FIFO | 1084/1169 | 92,73 | 32,83 |
| 30,00% | Loại | 1154/1169 | 98,72 | 34,95 |
| 30,00% | Đầy đủ | 1149/1169 | 98,29 | 34,80 |
Với ngân sách 20%, tổng năng lực là 779 lượt rà soát, gồm 355 và 424 ở hai ngày. Mô hình đầy đủ chọn trúng 768 lượt, cao hơn FIFO 37 lượt nhưng thấp hơn phương án chỉ dùng loại hai lượt. Chọn ngẫu nhiên có kỳ vọng 659,91 lượt trúng, precision 84,71% và recall 19,99%. Precision 98,59% của mô hình đầy đủ không đồng nghĩa bao phủ phần lớn tồn: recall chỉ đạt 23,26%. Hạn chế nguồn lực vẫn là nút thắt dù danh sách có tỷ lệ trúng cao.
Hình 2. Tỷ lệ bao phủ hồ sơ tiếp tục chưa đóng theo ngân sách rà soát
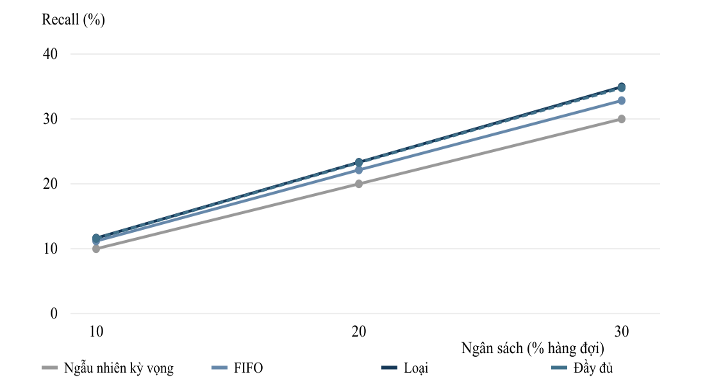
Khi tăng ngân sách từ 10% lên 30%, recall của mô hình đầy đủ tăng từ 11,57% lên 34,80%. Ở cả ba mức, mô hình chỉ dùng loại có số trúng cao hơn mô hình đầy đủ. Kết quả này cho thấy, cải thiện Brier không bảo đảm cải thiện top-K. Trong phạm vi mẫu, phương án chỉ dùng loại là lựa chọn thực dụng cho danh sách, còn mô hình đầy đủ có thể hỗ trợ trình bày mức rủi ro. Không nên chọn mô hình vận hành cuối cùng chỉ từ hai ngày kiểm tra này.
4.4. Độ tin cậy và giới hạn diễn giải
Hình 3. Xác suất trung bình dự báo và tỷ lệ chưa đóng quan sát theo khoảng xác suất
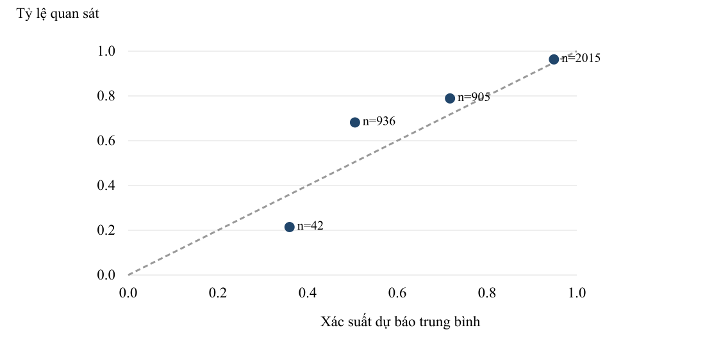
Nhóm dự báo 0,4-0,6 có 936 lượt, xác suất trung bình 0,5056 nhưng tỷ lệ quan sát 0,6816. Nhóm 0,8-1 có 2.015 lượt, hai giá trị tương ứng 0,9490 và 0,9633. Mô hình đánh giá thấp rủi ro ở một số khoảng; Brier thấp hơn không có nghĩa đã hiệu chỉnh tốt ở mọi nhóm. Không có quan sát trong khoảng dưới 0,2 nên không vẽ điểm cho khoảng này.
Có bốn giới hạn ảnh hưởng trực tiếp đến ứng dụng. Bản sao chỉ phủ khoảng một tuần, chưa đánh giá mùa vụ và không xác minh độc lập tính đầy đủ của bản xuất. Các hồ sơ lặp qua lát cắt làm số lượt lớn hơn số sự cố; mã khác nhau cũng có thể cùng phản ánh một hiện tượng. Ngày đóng không xác nhận sửa xong, còn thiếu ngày đóng có thể do cập nhật chậm. Cuối cùng, chọn hồ sơ thường xuyên tồn có thể dồn nguồn lực cho nhóm chậm hành chính, chưa chắc là nhóm nguy hiểm nhất. Chưa có mức độ nguy hiểm, chi phí sửa chữa, lịch đội công tác hoặc kiểm tra công bằng theo khu vực để giải quyết các hạn chế này.
5. Hàm ý và đề xuất
Ở ngân sách 20%, chênh lệch 37 lượt trúng giữa mô hình đầy đủ và FIFO cho thấy giá trị tiềm năng của phân tầng trước khi cán bộ đọc hồ sơ. Tuy nhiên, cách chỉ dùng loại còn nhỉnh hơn, nên đơn vị thí điểm có thể bắt đầu bằng bảng rủi ro theo loại phản ánh thay vì đầu tư ngay vào mô hình phức tạp. Ngưỡng cảnh báo nên gắn với số lượt rà soát thực có mỗi ngày; điểm xác suất cần hiển thị cùng thời điểm cập nhật và định nghĩa “chưa đóng”.
Danh sách này phù hợp để hỗ trợ rà soát, liên hệ và xác minh. Với triển khai thực địa, cần bổ sung mức độ nguy hiểm do cán bộ xác nhận, năng lực từng đội và chi phí công việc. Sự cố khẩn cấp phải theo quy trình ưu tiên nghiệp vụ trước khi xếp các việc thông thường. Không được chuyển trực tiếp thời gian chờ đóng hồ sơ thành giờ công. Với chi phí khác nhau, bài toán phải đổi sang ràng buộc tổng chi phí và điều kiện kỹ năng.
Để áp dụng tại đô thị Việt Nam, cần một giai đoạn chạy song song, chưa tự động điều phối, trên dữ liệu địa phương đủ dài. Đánh giá phải tách chất lượng cảnh báo, số lượt rà soát hữu ích và kết quả sửa chữa được xác nhận. Chỉ thử nghiệm tác động sau khi thống nhất định nghĩa hồ sơ, hạn xử lý và cách theo dõi các khu vực ít phản ánh. Mẫu New York hiện chỉ giúp kiểm chứng quy trình phân tích.
6. Kết luận
Bài viết nối cảnh báo tồn đọng với lựa chọn danh sách dưới giới hạn lượt rà soát bằng mô hình xác suất làm trơn và đánh giá theo thời gian. Trên hai lát cắt kiểm tra, mô hình đầy đủ dự báo xác suất tốt hơn tỷ lệ chung, nhưng danh sách chỉ dùng loại phản ánh đạt số trúng cao hơn tại cả ba ngân sách. Giá trị thực nghiệm nằm ở việc đo đúng mục tiêu quyết định và giữ rõ ranh giới giữa trạng thái hồ sơ với sửa chữa thực tế. Cần mở rộng thời gian, kiểm chứng nguồn dữ liệu và bổ sung chi phí, mức độ nguy hiểm trước khi đánh giá tác động giảm tồn đọng.
Tài liệu tham khảo:
City of New York. (n.d.-a). 311 service requests from 2020 to present [Data set]. NYC Open Data. https://data.cityofnewyork.us/Social-Services/311-Service-Requests-from-2020-to-Present/erm2-nwe9.
City of New York. (n.d.-b). FAQ – 311 reporting. https://www.nyc.gov/site/311reporting/faq/faq.page.
Kontokosta, C., Hong, B., & Korsberg, K. (2017). Equity in 311 reporting: Understanding socio-spatial differentials in the propensity to complain [Preprint]. arXiv. https://doi.org/10.48550/arXiv.1710.02452.
madelineswallows. (n.d.). NYC-311-Data-Cleaning [Data set and source code]. GitHub. https://github.com/madelineswallows/NYC-311-Data-Cleaning.
scikit-learn developers. (n.d.). Metrics and scoring: Quantifying the quality of predictions. https://scikit-learn.org/stable/modules/model_evaluation.html.
Tussey, D., & Yan, J. (2025). Principles for open data curation: A case study with the New York City 311 service request data [Preprint]. arXiv. https://doi.org/10.48550/arXiv.2502.08649.
Wang, L., Qian, C., Kontokosta, C., & Sobolevsky, S. (2016). Structure of 311 service requests as a signature of urban location [Preprint]. arXiv. https://doi.org/10.48550/arXiv.1611.06660.